데이터를 나눠 학습한 확산 모델은 왜 같은 그림을 그릴까
평균과 공분산, 그리고 랜덤 행렬 이론으로 본 확산 모델의 일관성
A Random Matrix Theory Perspective on the Consistency of Diffusion ModelsICML 2026 Oral, Outstanding Paper Honorable Mention
3줄 요약
- 겹치지 않는 데이터로 따로 학습한 확산 모델(diffusion model)은 같은 노이즈에서 거의 같은 이미지를 만든다. 이 논문은 그 상당 부분이 두 데이터가 공유하는 평균과 공분산, 즉 가우시안 통계만으로 예측된다는 것을 보인다.
- 랜덤 행렬 이론(random matrix theory, RMT)으로 보면 유한한 데이터의 효과는 노이즈 크기를 키우는 재정규화(renormalization) \(\sigma^2 \mapsto \kappa(\sigma^2)\)로 요약된다. 그래서 분산이 작은 방향이 과하게 깎이고 샘플이 평균 쪽으로 끌려간다.
- 두 모델이 어긋나는 정도는 방향(비등방성), 입력 위치(비균질성), 데이터 크기(전체 스케일링)의 곱으로 나뉜다. 이 예측은 UNet과 DiT에서도 경향 수준으로 맞는다.
선정 이유
ICML 2026 Oral이자 우수논문 가작(Outstanding Paper Honorable Mention)이다. 심사위원회는 이 논문이 기묘한 경험적 현상을 생성 모델 재현성의 수학적 기준선으로 바꿨다고 평했다.
블로그의 연구 여지 지도(NeurIPS, ICML, ICLR 2022~2026년 논문 7.9만 편, 150개 주제)에서 이 논문이 속한 ‘확산 모델 이론과 샘플링’은 LLM 중심 주제를 뺀 109개 주제 중 16위다. 1위 ’MCMC와 신경 샘플러’, 3위 ’플로우 매칭과 정규화 플로우’와 함께 샘플링과 생성 모델의 수학 묶음을 이루며, ICML 2026 최우수 논문(High-Accuracy Sampling for Diffusion Models and Log-Concave Distributions)도 같은 주제에 속한다.
- 전후로 아는 것이 달라졌나. 달라졌다. 서로 다른 데이터로 학습해도 결과가 같다는 관찰은 있었지만, 어디가 왜 일치하고 어디서 어긋나는지 예측하는 이론은 없었다. 이 논문이 그 기준선을 닫힌 형태로 준다.
- 새 질문을 여는가. 연다. 선형 이론이 설명하지 못하는 나머지 불일치의 출처가 바로 다음 질문이다. 데이터 공분산이 노이즈 공간에 축을 새긴다는 관찰은 시드(seed) 선택 문제로도 이어진다.
- 일반화될 근거가 있나. 9개 데이터 설정(FFHQ, AFHQ, CIFAR, LSUN의 32, 64픽셀)과 두 아키텍처에서 같은 경향이 나왔다. 다만 모두 저해상도 무조건부(unconditional) 픽셀 공간 모델이다.
- 증거가 주장만큼 강한가. 선형 모델에서는 이론과 수치가 거의 정확히 맞는다. 심층망에서는 경향만 맞고 불일치의 절대 크기는 이론보다 훨씬 크다. 저자들도 정성적 확인이라고 적는다.
왜 중요한가
GAN이나 VAE는 같은 잠재 벡터를 넣어도 학습할 때마다 다른 이미지가 나온다. 등방성 잠재 공간은 회전해도 분포가 같아서 축의 의미가 학습마다 달라지기 때문이다. 반면 확산 모델은 결정론적 샘플러인 확률 흐름 ODE(probability flow ODE)를 쓰면 데이터 분할, 아키텍처, 초기화가 달라도 같은 노이즈가 비슷한 이미지로 간다.
이 현상은 일반화(generalization)와 암기(memorization) 논쟁의 한가운데에 있다. 다른 데이터에서 같은 결과가 나온다면 모델은 개별 이미지가 아니라 분포의 공통 구조를 배운 것이다. 그러면 결과물의 어느 부분이 공통 구조이고 어느 부분이 특정 학습 데이터의 흔적인지 가를 기준이 필요하다. 블로그의 해석으로는 재현성과 데이터 기여도(data attribution) 논의도 이 기준에 기댄다.
핵심 아이디어
직관: 평균과 공분산이 같으면 결과도 비슷하다
저자들은 FFHQ32를 3만 장씩 겹치지 않게 나눠 UNet과 DiT를 각각 학습하고 같은 노이즈로 샘플링했다(3장, 그림 1). 네 모델의 결과는 서로 비슷했고, 각자 가장 가까운 학습 이미지보다 서로에게 더 가까웠다. 암기로는 설명되지 않는 일치다.
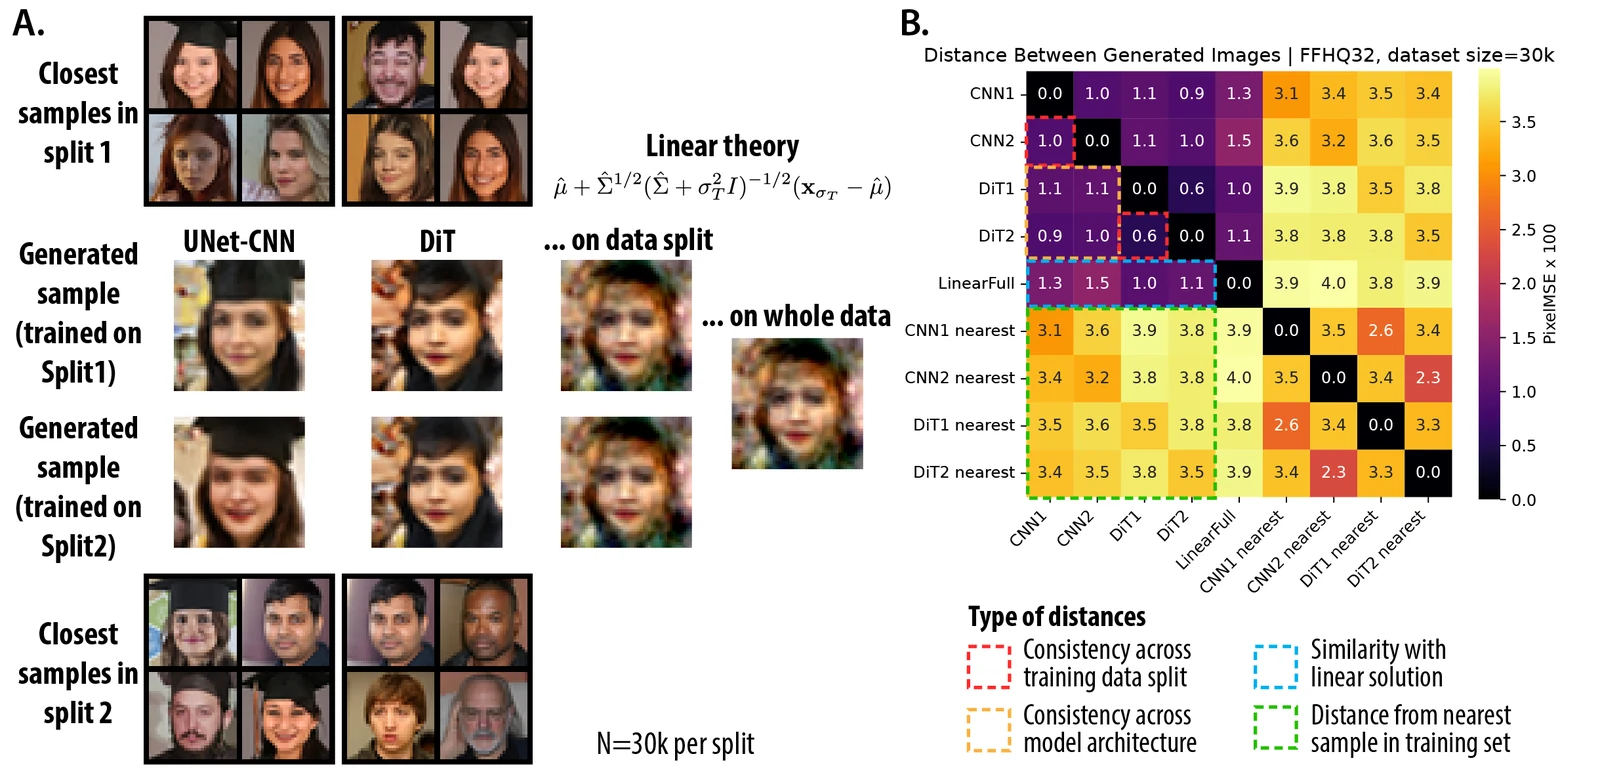
눈여겨볼 대목은 따로 있다. 분할별 평균과 공분산만으로 만든 선형 예측기, 곧 위너 필터(Wiener filter)가 이 결과를 상당 부분 맞힌다. 가우시안 해에 가까운 샘플일수록 분할 간 일관성도 높았다(Pearson \(r=0.244\)). 반대로 두 번째 주성분 기준으로 데이터를 나눠 평균과 분산을 어긋나게 하면 일관성이 눈에 띄게 떨어졌다(부록 B.2).
(가) 겹치지 않는 두 분할
(나) 방향마다 다르게 줄이는 선형 디노이저
방법: 선형 디노이저에서 출발한다
선형 디노이저(linear denoiser)를 학습하면 데이터는 처음 두 모멘트로만 들어온다. 최적해는 다음과 같다(식 2).
\[ \mathbf{D}_{\hat\Sigma}(\mathbf{x};\sigma)=\hat\mu+(\hat\Sigma+\sigma^2 I)^{-1}\hat\Sigma\,(\mathbf{x}-\hat\mu) \]
그러면 질문은 표본 공분산 \(\hat\Sigma\)가 데이터 뽑기에 따라 얼마나 흔들리고 그 흔들림이 결과에 어떻게 전해지는가로 바뀐다. 이때 결정론적 등가(deterministic equivalence)라는 RMT 도구를 쓴다(4.1절, 식 DE와 식 4).
\[ \hat\Sigma(\hat\Sigma+\lambda I)^{-1}\asymp\Sigma\big(\Sigma+\kappa(\lambda) I\big)^{-1},\qquad \kappa(\lambda)-\lambda=\gamma\,\kappa(\lambda)\,\mathrm{tr}\big[\Sigma(\Sigma+\kappa(\lambda)I)^{-1}\big] \]
\(\gamma=d/n\)은 차원 대 표본 수의 비, tr은 정규화된 대각합이다. 표본 공분산의 무작위성을 노이즈가 실제보다 큰 것처럼 스칼라 \(\kappa\) 하나에 흡수한다는 것이 핵심이다. 식에서 바로 \(\kappa(\lambda)>\lambda\)가 나오며, 이 효과는 노이즈가 작을수록, 표본이 차원에 비해 적을수록 커진다.
그래서 디노이저의 기댓값은 노이즈를 \(\kappa(\sigma^2)\)로 키운 모집단 디노이저와 같아진다(결과 4.1, 식 6). 적응형 릿지(ridge) 벌점을 더한 셈이어서, 분산이 작은 방향인 세부 묘사를 노이즈로 보고 더 세게 깎아 출력을 평균 쪽으로 끌어당긴다.
최종 샘플에는 행렬 제곱근이 들어간다. 저자들은 \(\hat\Sigma^{1/2}=\frac{2}{\pi}\int_0^\infty \hat\Sigma(\hat\Sigma+u^2 I)^{-1}\,du\)로 제곱근을 디노이저 모양의 적분으로 바꿔 같은 도구를 적용했다(5장, 부록 C.4). 그 결과 과수축(overshrinkage)이 모든 노이즈 스케일에 걸쳐 합쳐진 형태로 샘플에 나타난다(결과 5.1, 식 9).
수식: 어디서 어긋나는가
분할 간 흔들림, 즉 분산은 세 요인의 곱으로 나뉜다(결과 4.2, 식 7). 아래에서 \(\kappa=\kappa(\sigma^2)\)이고 표기는 원문보다 조금 줄였다.
\[ \mathrm{Var}_{\hat\Sigma}\big[\mathbf{v}^\top\mathbf{D}_{\hat\Sigma}(\mathbf{x};\sigma)\big]\asymp \frac{\kappa^2}{n-\mathrm{df}_2(\kappa)}\; \underbrace{\Diamond(\mathbf{v})}_{\text{anisotropy}}\; \underbrace{\Diamond(\mathbf{x}-\mu)}_{\text{inhomogeneity}}, \qquad \Diamond(\mathbf{u})=\mathbf{u}^\top(\Sigma+\kappa I)^{-2}\Sigma\,\mathbf{u} \]
- 비등방성(anisotropy): 고윳값 \(\lambda_k\)인 주성분 방향에서 이 항은 \(\lambda_k/(\lambda_k+\kappa)^2\)이고 \(\lambda_k=\kappa\)에서 최대다. 즉 가장 흔들리는 방향은 분산이 재정규화된 노이즈와 비슷한 방향이다. 그래서 노이즈가 크면 얼굴 윤곽 같은 저주파에서, 작으면 반사광 같은 고주파 세부에서 두 모델이 어긋난다.
- 비균질성(inhomogeneity): 입력이 분산이 큰 방향으로 평균에서 멀리 있을수록 불일치가 크다. 덕분에 입력별 불일치를 점 단위로 예측할 수 있고, 선형 디노이저에서 예측과 실제의 상관은 Pearson \(r=0.94\)였다(\(\sigma^2=1\), \(n=1000\)).
- 전체 스케일링(global scaling): 데이터가 많으면 분산은 \(1/n\)로 줄고, 적을 때는 재정규화가 이 스케일링을 바꾼다.
(가) 유한한 데이터의 과수축
(나) 가장 크게 어긋나는 방향
결과 해설
심층망의 두 국면(6장, 그림 5A, 5B). 분할 크기 \(n\)을 300부터 3만까지 바꿔 UNet은 9개 설정 전부, DiT는 일부에서 학습했다. \(n\le1000\)에서는 샘플이 학습 이미지를 대체로 재현하는 암기 국면으로, 선형 이론의 범위 밖이다. \(n\ge3000\)부터는 학습 분할과 대조 분할까지의 거리가 비슷해지는 재정규화 국면이고, \(n\)이 커질수록 샘플이 선형 예측기에 가까워진다. \(n=3000\)에서는 예측대로 과수축이 보여 얼굴이 평균 얼굴처럼 매끈해지고 중하위 고유 모드의 분산이 모자란다. 이 편향은 \(n\)이 3만 무렵이면 사라진다.
어디서 어긋날지 예측하기(6장, 그림 5E, 5F). 고유 모드별 분할 간 차이는 이론이 예측한 비등방성 모양을 따른다. \(n\)을 늘리면 차이는 주로 상위 모드에서 줄고, 중하위 모드는 그대로이거나 오히려 덜 일관해진다. 세부 묘사가 일관되려면 훨씬 많은 데이터가 필요하다. 시드별로는 모집단 공분산과 \(n\)만 넣은 RMT 예측이 FFHQ64 UNet(\(n=30000\))의 실제 불일치와 Spearman 0.33(시드 1,000개, \(p=2.5\times10^{-26}\))으로 상관했다. 분할이나 아키텍처 정보 없이 나온 예측이다.
의심해볼 점
- 선형 이론은 기준선이다. 평균과 공분산으로 설명되는 부분만 다룬다. 심층망의 불일치가 이론보다 훨씬 크다는 것은 설명되지 않은 비선형 요인이 크다는 뜻이다. “일관성은 가우시안 통계 때문”이 아니라 “일관성의 상당 부분은”으로 읽어야 한다.
- 가정. 평균 추정 오차를 무시하고(\(\hat\mu=\mu\)) 공분산의 흔들림만 본다. 저자들은 높은 노이즈에서 이론이 덜 맞는 이유를 경험적 평균의 차이로 추정한다(부록 B.3). 샘플 결과는 초기 노이즈가 매우 크다는 근사와 고차원 극한에 기댄다.
- 실험 범위. 32, 64픽셀 무조건부 픽셀 공간 모델이고 기본 학습은 5만 스텝이다. 25만 스텝까지 늘리면 샘플은 선형 예측기로 다가갔다가 멀어지고, 멀어질수록 분할 간 일관성도 낮아지며, 데이터가 적을수록 이탈이 일찍 온다(부록 B.4.7). 텍스트 조건부 모델, 잠재 확산(latent diffusion), 대형 모델에서도 같은 구조가 유지되는지는 아직 모른다.
- 범위 밖의 샘플러. 분석 대상은 결정론적 ODE의 샘플링 사상(sampling map)이며, 확률적 샘플러의 일관성은 다루지 않는다.
리뷰어들이 짚은 점
ICML 2026 심사 기록은 OpenReview에 공개돼 있다. 리뷰어 네 명은 최종적으로 모두 수락(5점)을 줬고, 쟁점은 대부분 선형 이론이 어디까지 통하느냐에 모였다.
- 선형 이론과 실제 모델 사이의 다리. 한 리뷰어는 선형으로 단순화한 모델이 실제로 학습된 비선형 모델과 어떻게 이어지는지 근거가 부족하다고 봤다. 그림 1과 6의 생성 품질이 EDM으로 얻을 수 있는 수준보다 눈에 띄게 낮아 학습이 덜 된 것 아니냐는 지적도 했다. 저자들은 학습 도중 생성 샘플과 선형 예측기 사이의 평균 제곱 오차를 추적하는 실험을 추가했다. 모든 모델이 학습 초반에 선형 예측기에 가장 가까워졌다. 그 뒤 암기 국면(분할 크기 300, 1,000)에서는 오차가 최소값의 약 2.8배로 다시 벌어졌지만, 일반화 국면(30,000)에서는 1.08배에 그쳤다. 이 리뷰어는 답변을 보고 점수를 3점에서 5점으로 올렸다.
- 같은 도구를 쓴 선행 연구. 선형 디노이저를 랜덤 행렬 이론으로 분석한 흐름이 이미 있다는 지적이 나왔다. OptShrink, Gavish와 Donoho의 최적 특잇값 수축, Cui와 Zdeborová의 디노이징 오토인코더 점근 분석 등이다. 깊은 선형망이나 학습 동역학까지 넣을 수 있는지도 질문으로 남았다.
- 가우시안 가정의 범위. 설명이 공유된 가우시안 통계에 크게 기대므로 가우시안이 아닌 데이터에서는 어떤가라는 질문이 나왔다. 저자들은 준가우시안(sub-Gaussian) 분포까지는 랜덤 행렬의 보편성 결과로 넘어가지만, 꼬리가 두꺼운 분포에서는 일관성이 떨어질 수 있다고 답했다. 같은 리뷰어는 생성 데이터의 공분산을 일관되게 추정하는 방향도 제안했고, 저자들은 이를 Ledoit-Wolf 류의 수축 추정과 연결했다.
- 설명하지 못한 것. 고차 모멘트, 아키텍처 사이의 차이, 그리고 GAN과 VAE에서는 왜 같은 현상이 없는지가 질문으로 나왔다. 저자들은 아키텍처 차이는 아직 설명하지 못한다고 인정했다. GAN과 VAE는 등방성 잠재 공간을 회전해도 같은 분포가 나오기 때문에, 학습마다 축이 달라질 수 있다고 답했다.
계보
- Kadkhodaie, Guth, Simoncelli, Mallat (ICLR 2024 Outstanding Paper): 겹치지 않는 데이터로 학습한 두 디노이저가 데이터가 충분하면 거의 같은 점수 함수를 배운다는 것을 보였다. 이 논문의 출발 관찰이다.
- Zhang et al. (ICML 2024): 이 현상을 일관된 모델 재현성(consistent model reproducibility)이라 부르고 암기 국면과 일반화 국면을 나눴다.
- Wang, Vastola (TMLR)와 Li, Dai, Qu (NeurIPS 2024): 학습된 점수 함수의 상당 부분이 가우시안 근사로 설명된다는 숨은 선형 구조를 보였다.
- Atanasov, Zavatone-Veth, Pehlevan: 고차원 회귀의 스케일링과 재정규화. \(\kappa\)를 재정규화된 릿지로 읽는 관점의 배경이다.
- 옆 갈래: Kamb, Ganguli (2024), Niedoba et al. (2024), Lukoianov et al. (2025)은 국소성(locality)과 패치 조합으로 일반화를 설명한다. 가우시안 기준선이 놓친 부분을 채울 후보다. Bonnaire et al. (NeurIPS 2025)은 두 시간 척도로 암기가 늦게 오는 이유를 설명한다.
- 후속: 인용 4편(Semantic Scholar, 2026년 9월). Maillard, Goldt (2026)는 선형 생성 모델에서 암기가 일반화로 넘어가는 전이를 해석적으로 정확히 풀었다.
열린 질문
- 가우시안 너머의 불일치. 선형 이론이 설명하지 못하는 심층망의 나머지 불일치는 어떤 데이터 통계에서 오는가. 국소 패치 통계나 고차 모멘트를 반영한 기준선은 이 간극을 얼마나 메우는가. 꼬리가 두꺼운 데이터에서는 일관성이 어떤 모양으로 무너지는가.
- 조건부 모델과 잠재 공간. 텍스트 조건부 모델이나 잠재 확산에서도 불일치의 스펙트럼 지도가 유지되는가. 유지된다면 어떤 공분산이 기준이 되는가.
- 노이즈 공간의 기하. 데이터 공분산이 초기 노이즈 공간에 축을 새긴다면, 시드의 안정성과 품질은 이 축으로 얼마나 설명되는가.
이해 확인
1. 표본이 유한한 선형 디노이저가 샘플을 평균 쪽으로 끌어당기는 까닭은?
- 표본 공분산이 모든 방향의 분산을 크게 잡기 때문이다
- 유한한 데이터의 효과가 노이즈를 σ²보다 큰 κ(σ²)로 본 것과 같아서, 분산이 작은 방향을 더 세게 줄이기 때문이다
- 학습이 덜 되어 디노이저가 평균만 내놓기 때문이다
- 두 분할의 평균이 달라서 그 중간으로 가기 때문이다
모집단 디노이저는 분산이 λ인 방향을 λ/(λ+σ²)만큼 남긴다. 표본이 유한하면 기댓값이 σ² 대신 더 큰 κ(σ²)를 넣은 것과 같아진다(결과 4.1). 두 계수의 비 (λ+σ²)/(λ+κ)는 λ가 작을수록 더 작으므로, 세부 묘사 같은 저분산 방향이 상대적으로 더 깎이고 샘플은 평균 쪽으로 끌려간다.
2. 노이즈 수준이 정해졌을 때, 두 분할의 디노이저가 가장 크게 어긋나는 주성분 방향은?
- 분산이 가장 큰 방향
- 분산이 가장 작은 방향
- 분산이 재정규화된 노이즈 κ와 비슷한 방향
- 방향과 상관없이 고르게 어긋난다
어긋남의 비등방성 항은 λ/(λ+κ)²이라 λ = κ에서 가장 크다. 분산이 훨씬 큰 방향은 두 디노이저 모두 거의 그대로 통과시키고, 훨씬 작은 방향은 둘 다 거의 0으로 누르니 의견이 같다. 자연 이미지는 저주파일수록 분산이 커서, 노이즈가 크면 윤곽에서, 작으면 세부에서 어긋난다.
3. 시드별 불일치를 RMT로 예측할 때 필요하지 않은 정보는?
- 모집단 공분산의 고윳값과 고유벡터
- 데이터 크기 n
- 초기 노이즈
- 어떤 분할로 학습했고 어떤 아키텍처를 썼는지
예측에는 모집단 공분산, 데이터 크기, 초기 노이즈만 들어간다. 분할과 아키텍처 정보 없이도 FFHQ64 UNet의 실제 불일치와 스피어만 0.33으로 상관했다. 다만 n이 1,000 이하인 암기 국면에서는 결과가 개별 학습 이미지에 달려 있어 이 예측이 무너진다.
논문 정보
- 제목: A Random Matrix Theory Perspective on the Consistency of Diffusion Models
- 저자: Binxu Wang, Jacob A. Zavatone-Veth, Cengiz Pehlevan (Harvard University)
- 학회: ICML 2026 Oral, Outstanding Paper Honorable Mention
- 링크: arXiv 2602.02908, OpenReview, 프로젝트 페이지, 코드